
فهرست مطالب (۱۰ بخش)
- ساخت صدای زنانه و مردانه با تغییر صدا چه فرقی دارد؟
- صدای دختر با هوش مصنوعی را چطور طبیعیتر انتخاب کنیم؟
- ElevenLabs v3 و MiniMax Speech 2.8 HD چه تفاوتی دارند؟
- آموزش ساخت صدای دختر با هوش مصنوعی در ZarinGPT
- متن فارسی را چطور برای خواندن آماده کنیم؟
- چهار خروجی را چطور منصفانه مقایسه کنیم؟
- اشکالهای رایج در خروجی و راه اصلاح آنها
- استفادهٔ رایگان و انتشار تجاری چه شرایطی دارند؟
- سؤالات متداول
- قدم بعدی
خلاصه در یک نگاه
- مدل، گوینده و زبان سه انتخاب جدا هستند؛ نام مدل زنانه یا مردانه بودن صدا را تعیین نمیکند.
- ElevenLabs v3 و MiniMax Speech 2.8 HD هر دو طبق مستندات رسمی فارسی را پشتیبانی میکنند.
- نامها، عددها و مکثها را با متن کوتاه بسنجید و هر بار فقط یک ویژگی را تغییر دهید.
- برای انتشار تجاری مجوز سرویس را بررسی کنید و صدای فرد واقعی را بدون اجازه بازسازی نکنید.
صدای دختر با هوش مصنوعی را میتوانید از روی متن فارسی و با انتخاب گویندهٔ زن بسازید و برای صدای مرد هم همین مسیر را با گویندهٔ مناسب طی میکنید. ElevenLabs v3 و MiniMax Speech 2.8 HD هر دو طبق مستندات رسمی از زبان فارسی پشتیبانی میکنند. برای شروع، متنی ۲ تا ۳ جملهای آماده کنید و پیش از تولید نریشن کامل، تلفظ و لحن همان نمونه را بشنوید.
ساخت صدای زنانه و مردانه با تغییر صدا چه فرقی دارد؟
در ساخت گفتار، متن را میدهید و مدل آن را با گویندهٔ انتخابی میخواند. برای مثال، میتوانید معرفی محصول را با دو صدای متفاوت بسازید و تصمیم بگیرید کدامیک با لحن برند هماهنگتر است. در این راهنما، اصطلاح دختر و پسر به انتخاب صدای زنانه و مردانه برای گویندگی اشاره دارد، نه ساخت هویت جعلی یا تقلید صدای شخصی مشخص.
اگر صدای ضبطشده دارید و میخواهید ویژگیهای آن را تغییر دهید، به ابزاری برای تبدیل صدا نیاز دارید. شبیهسازی صدای یک فرد هم کار دیگری است که به نمونهٔ صوتی، قابلیت مناسب و مجوز استفاده وابسته است. وجود مدل گفتارساز در یک پنل به معنی فعال بودن این دو امکان نیست.
جدول زیر کمک میکند ابزار را بر اساس ورودی و نتیجهٔ دلخواه انتخاب کنید.
| مسیر | ورودی | خروجی مورد انتظار |
|---|---|---|
| ساخت گفتار از متن | متن آمادهٔ خواندن | نریشن با گویندهٔ انتخابی |
| تبدیل صدای ضبطشده | فایل صوتی | تغییر ویژگیهای صدا، در ابزار دارای این قابلیت |
| شبیهسازی صدای فرد | نمونهٔ صدا با اجازهٔ صاحب آن | صدای مشابه، با رعایت شرایط سرویس |
صدای دختر با هوش مصنوعی را چطور طبیعیتر انتخاب کنیم؟
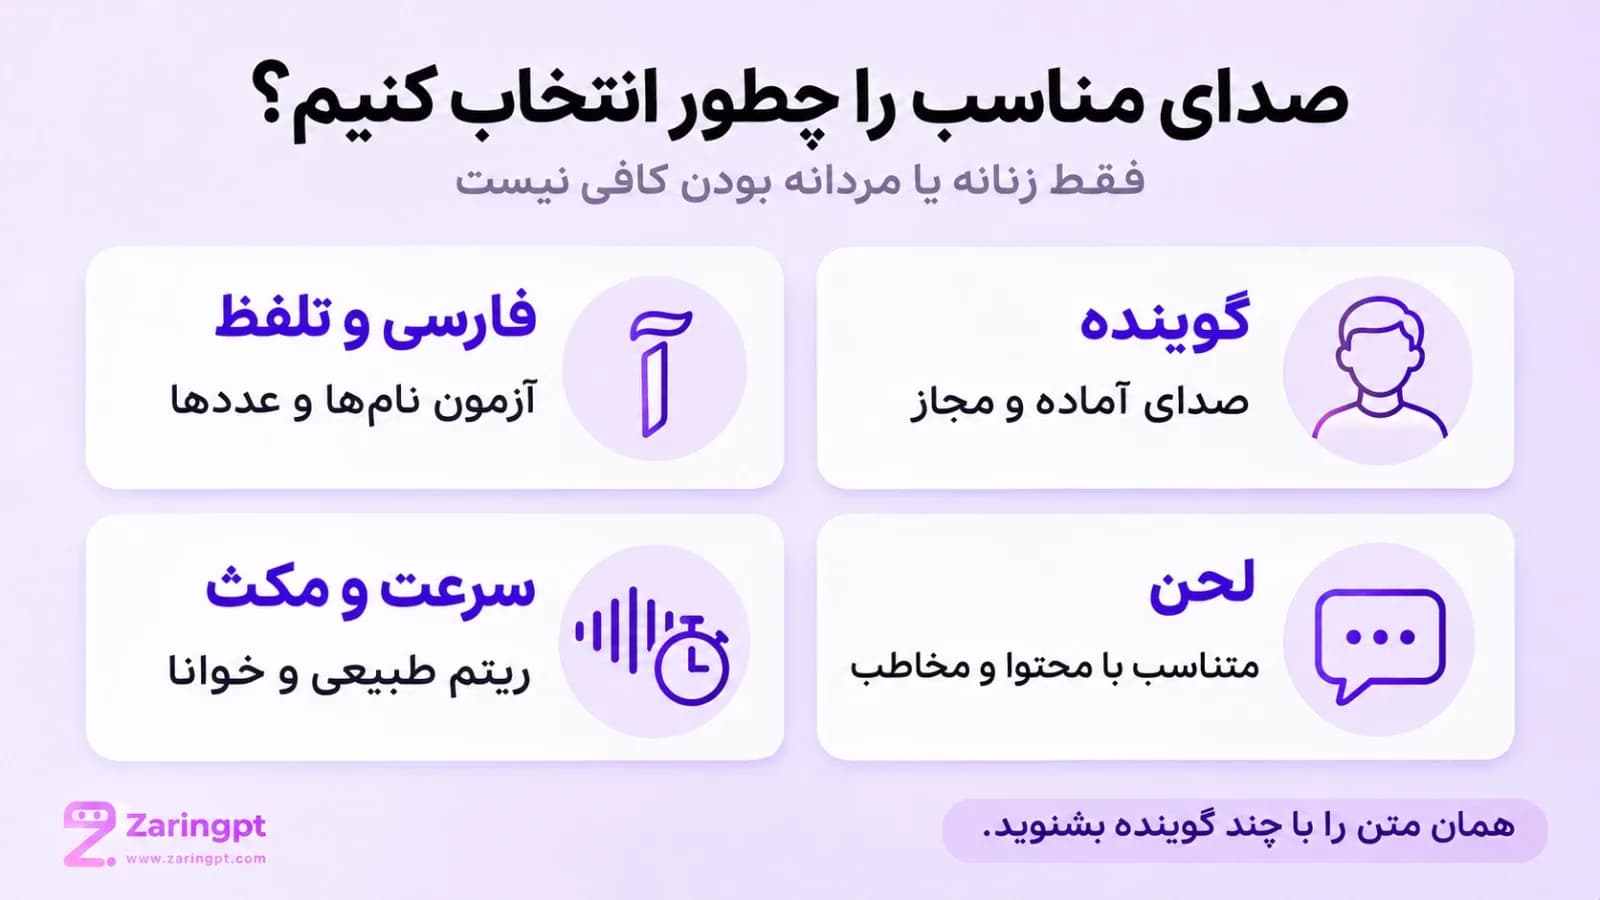
طبیعی بودن فقط به زیر یا بم بودن صدا وابسته نیست. تلفظ فارسی، جای مکث، وضوح واژهها و هماهنگی لحن با محتوا، همگی بر نتیجه اثر دارند. برای ساخت صدای دختر با هوش مصنوعی، ابتدا گویندهای را پیدا کنید که نمونهٔ خواندنش با نوع پروژه هماهنگ باشد و بعد تنظیمات را روی همان متن امتحان کنید.
در کتابخانهٔ رسمی ElevenLabs فیلترهایی مانند زبان، لهجه، جنسیت، سن و کاربرد وجود دارد. این امکانات مربوط به محیط خود ElevenLabs است و لزوماً همهٔ آنها در ZarinGPT نمایش داده نمیشوند. در پنل واسط، گویندهها و گزینههای همان مدل را ملاک قرار دهید و اگر انتخاب موردنیاز را نمیبینید، پیش از تولید متن بلند از پشتیبانی دربارهٔ روش انتخاب گوینده بپرسید.
گوینده را با کاربرد بسنجید
برای آموزش، صدایی واضح و با بلندی متعادل میتواند مناسب باشد، اما معرفی پرانرژی محصول ممکن است اجرای متفاوتی بخواهد. وقتی بهدنبال وایس دخترانه برای محتوای خودتان هستید، بهجای انتخاب صرفاً بر اساس نام یا برچسب گوینده، همان جمله را با چند گوینده بشنوید و ببینید کدامیک پیام را روشنتر منتقل میکند. برای صدای مردانه هم همین معیار را حفظ کنید.
سرعت را جای لحن عوض نکنید
تندتر کردن همهٔ جملهها لزوماً اجرا را شادتر نمیکند و پایین آوردن زیر و بمی هم بهتنهایی صدای مناسبی برای نریشن مردانه نمیسازد. ابتدا گویندهٔ نزدیکتر به حس دلخواه را انتخاب کنید و بعد سرعت یا مکث را، در صورت وجود تنظیم مربوط، کمی تغییر دهید. دستکاری شدید چند ویژگی معمولاً تشخیص علت مشکل را سختتر میکند.
ElevenLabs v3 و MiniMax Speech 2.8 HD چه تفاوتی دارند؟
این دو مدل متن را به گفتار تبدیل میکنند و هر دو در مستندات رسمی از فارسی پشتیبانی میکنند. تفاوت کاربردی را باید در شیوهٔ کنترل اجرا، گویندههای در دسترس و نتیجهٔ همان متن جستوجو کرد. جدول زیر مقایسهٔ قابلیتهای مستند است و رتبهبندی کیفیت شنیداری یا گزارش تست این دو مدل نیست.
| معیار | ElevenLabs v3 | MiniMax Speech 2.8 HD |
|---|---|---|
| پشتیبانی فارسی | در فهرست رسمی زبانهای v3 | در راهنمای زبانها و API |
| انتخاب صدا | گویندهٔ انتخابی و امکانات محیط دسترسی | شناسهٔ گوینده و امکانات محیط دسترسی |
| کنترل اجرای گفتار | تگهای صوتی و نشانهگذاری متن | کنترل سرعت، زیر و بمی، بلندی و حس گفتار در API |
| مکث | تگ صوتی و نشانهگذاری، بدون پشتیبانی SSML break | نشانهٔ مکث اختصاصی در API |
| ملاک استفاده در ZarinGPT | گزینههای فعال همان پنل | گزینههای فعال همان پنل |
ElevenLabs اکنون مدل جدیدتری مثل Eleven v4 هم معرفی کرده، اما در این راهنما روش کار با v3 را بررسی میکنیم. نام «Eleven v3» در فهرست مدلهای ZarinGPT به همین خانواده اشاره دارد. همچنین طبق مستندات MiniMax، سریهای قدیمی speech-01 و speech-02 فعلاً فارسی را پشتیبانی نمیکنند و این محدودیت را نباید به Speech 2.8 HD تعمیم داد. هنگام بررسی پشتیبانی فارسی، نام دقیق نسخهٔ مدل را با مستندات آن تطبیق دهید.
آموزش ساخت صدای دختر با هوش مصنوعی در ZarinGPT
برای ساخت صدای دختر با هوش مصنوعی در این پلتفرم، از دستهٔ صدا یکی از دو مدلِ بررسیشده را انتخاب کنید و ابتدا نمونهای کوتاه بسازید. راهنمای عمومی سایت مسیر انتخاب مدل را توضیح میدهد، اما برای انتخاب گوینده و تنظیم لحن باید گزینههای فعال داخل حساب خودتان را هم بررسی کنید. اگر تنظیم گوینده یا لحن را میبینید، همان گزینه را بهجای دستورهای مبهم در متن به کار ببرید.
۱. متن گفتاری را آماده کنید
متنی را بنویسید که واقعاً باید شنیده شود، نه متنی شبیه یادداشت نویسنده. برای مثال، بهجای «گوینده با لحن گرم بگوید فروش شروع شد» فقط جملهٔ نهایی را در کادر خواندن قرار دهید. نام برند، عدد و تاریخ را هم به شکلی بنویسید که تلفظ موردنظر روشن باشد، چون مدل ممکن است اختصار یا عدد را متفاوت از انتظار بخواند.
۲. مدل و گوینده را جدا انتخاب کنید
پس از بررسی اشتراک فعال و موجودی حساب، منوی انتخاب مدل را در دستهٔ صدا باز کنید و Eleven v3 یا MiniMax Speech 2.8 HD را انتخاب کنید. اگر گزینهٔ انتخاب گوینده و زبان در دسترس است، گویندهٔ زن یا مرد و زبان فارسی را تعیین کنید. برای جزئیات حساب و انتخاب مدل، راهنمای استفاده از ZarinGPT را ببینید و وجود فیلترهای سرویس اصلی را در پنل واسط فرض نکنید.
۳. نمونهای کوتاه تولید کنید
برای اولین آزمون صدای دختر با هوش مصنوعی، جملهای شامل یک نام و یک عدد کافی است تا تلفظهای حساس را بشنوید. اگر تنظیم مستقلی برای سرعت یا شیوهٔ اجرا وجود دارد، ابتدا آن را نزدیک حالت پیشفرض نگه دارید. بعد از انتخاب گویندهٔ مناسب، فقط ویژگیای را تغییر دهید که واقعاً به اصلاح نیاز دارد.
۴. فایل را در زمینهٔ نهایی بشنوید
نریشن را روی ویدیوی اصلی یا در کنار موسیقی پسزمینه امتحان کنید، چون صدایی که بهتنهایی واضح است ممکن است میان افکتها گم شود. برای نسخهٔ مردانه هم متن یکسان را نگه دارید تا بتوانید تفاوت اجرای گویندهها را مقایسه کنید. پس از انتخاب، فایل را با نام مدل، نام گوینده و تاریخ ذخیره کنید تا در اصلاحات بعدی بدانید کدام اجرا مبنا بوده است.
متن فارسی را چطور برای خواندن آماده کنیم؟
برای تبدیل متن به صدای زن، ابتدا جملههای نوشتاری سنگین را به بیان گفتاری روشن تبدیل کنید. منظور از گفتاری، شکستن بیدلیل جملهها یا محاورهای کردن همهٔ متن نیست. هر جمله باید ادامهٔ طبیعی قبلی باشد و نقطه و ویرگول به مدل کمک کنند مرز عبارتها را تشخیص دهد.
عددهایی مثل قیمت، ساعت و شمارهٔ سفارش را در آزمون اولیه به حروف بنویسید تا تلفظ موردنظر مشخص شود. برای نامهای خارجی هم نوشتاری نزدیک به تلفظ دلخواه را امتحان کنید و اگر لازم بود فقط همان واژه را با حرکتگذاری روشنتر بنویسید. این راهکارها نقطهٔ شروعاند و نتیجه را باید با گویندهٔ انتخابی دوباره بشنوید.
نمونهٔ متن اطلاعرسانی
این متن برای بررسی وضوح جملهها و خواندن ساعت مناسب است و میتوانید آن را بدون افزودن توضیح اجرای صدا در کادر گفتار قرار دهید. برای مقایسهٔ زنانه و مردانه، واژهها و نشانهگذاری را در همهٔ اجراها یکسان نگه دارید.
پرامپت آماده
سلام، به فروشگاه ما خوش آمدید. سفارشهای ثبتشده تا ساعت چهار عصر، امروز آمادهٔ ارسال میشوند. برای دریافت راهنمای انتخاب محصول، مشخصات موردنیازتان را در بخش پشتیبانی بنویسید.
پرامپت و مدل در چت ZarinGPT آماده میشود؛ متن را بررسی کنید و ارسال بزنید.
نمونهٔ معرفی آموزشی
در متن آموزشی، سرعت بیش از حد میتواند دنبال کردن مراحل را دشوار کند. این نمونه را با صدایی روشن و متعادل امتحان کنید و بررسی کنید که گوینده بعد از جملهٔ اول مکث مناسبی دارد و پایان جملهها را نمیبلعد.
پرامپت آماده
برای شروع، فایل موردنظر را انتخاب کنید و نام آن را بررسی کنید. بعد، کیفیت خروجی را متناسب با کاربردتان تعیین کنید. پیش از ذخیرهٔ نسخهٔ نهایی، چند ثانیه از ابتدا و انتهای فایل را بشنوید.
پرامپت و مدل در چت ZarinGPT آماده میشود؛ متن را بررسی کنید و ارسال بزنید.
دستور اجرا را کجا بنویسیم؟
اگر ابزار کادر مستقلی برای دستور اجرا دارد، توضیحی مثل «آرام، روشن و با مکث طبیعی» را در همان بخش قرار دهید. در غیر این صورت، دستور آزاد را با متن گفتار مخلوط نکنید، چون ممکن است مدل آن را بخواند. تگهای کنترلی هم فقط زمانی مفیدند که مدل و مسیر دسترسی از همان قالب پشتیبانی کنند.
برای نمونه، ElevenLabs v3 از تگهای صوتی، یعنی نشانههای کنترلی اجرا مثل [whispers]، پشتیبانی میکند، اما تگ مکث SSML break را نمیپذیرد. MiniMax در API نشانهٔ مکث اختصاصی دارد که با قالب ElevenLabs یکسان نیست. این تفاوت فنی دلیل خوبی است که کد یا تگ یک سرویس را بدون بررسی در سرویس دیگر کپی نکنید، بهویژه وقتی فقط به خروجی سادهٔ نریشن نیاز دارید.
چهار خروجی را چطور منصفانه مقایسه کنیم؟
برای ارزیابی صدای دختر با هوش مصنوعی در کنار صدای مردانه، متن اطلاعرسانی بالا را با هر دو مدل اجرا کنید و در هر مدل یک گویندهٔ زن و یک گویندهٔ مرد انتخاب کنید. با این روش، دو خروجی از ElevenLabs v3 و دو خروجی از MiniMax Speech 2.8 HD خواهید داشت. نام گوینده و تنظیمات را ثبت کنید و هنگام شنیدن فایلها، بلندی پخش را تا حد امکان یکسان نگه دارید تا صدای بلندتر بهاشتباه بهتر به نظر نرسد.
در هر فایل به تلفظ نامها، خواندن عدد، طبیعی بودن مکث، وضوح واژهها و هماهنگی لحن با کاربرد گوش دهید. اگر یکی از صداها مناسب نبود، پیش از تغییر مدل، گویندهٔ دیگری را هم امتحان کنید.
اشکالهای رایج در خروجی و راه اصلاح آنها
برای اصلاح صدای دختر با هوش مصنوعی، ابتدا مشخص کنید مشکل از متن، گوینده یا تنظیمات است. اگر فقط نام برند اشتباه خوانده میشود، تغییر همهٔ ویژگیهای صدا کمکی به شناخت مسئله نمیکند. اگر فقط همان واژه را اصلاح کنید، راحتتر میتوانید نتیجهٔ اجرای تازه را با قبلی مقایسه کنید.
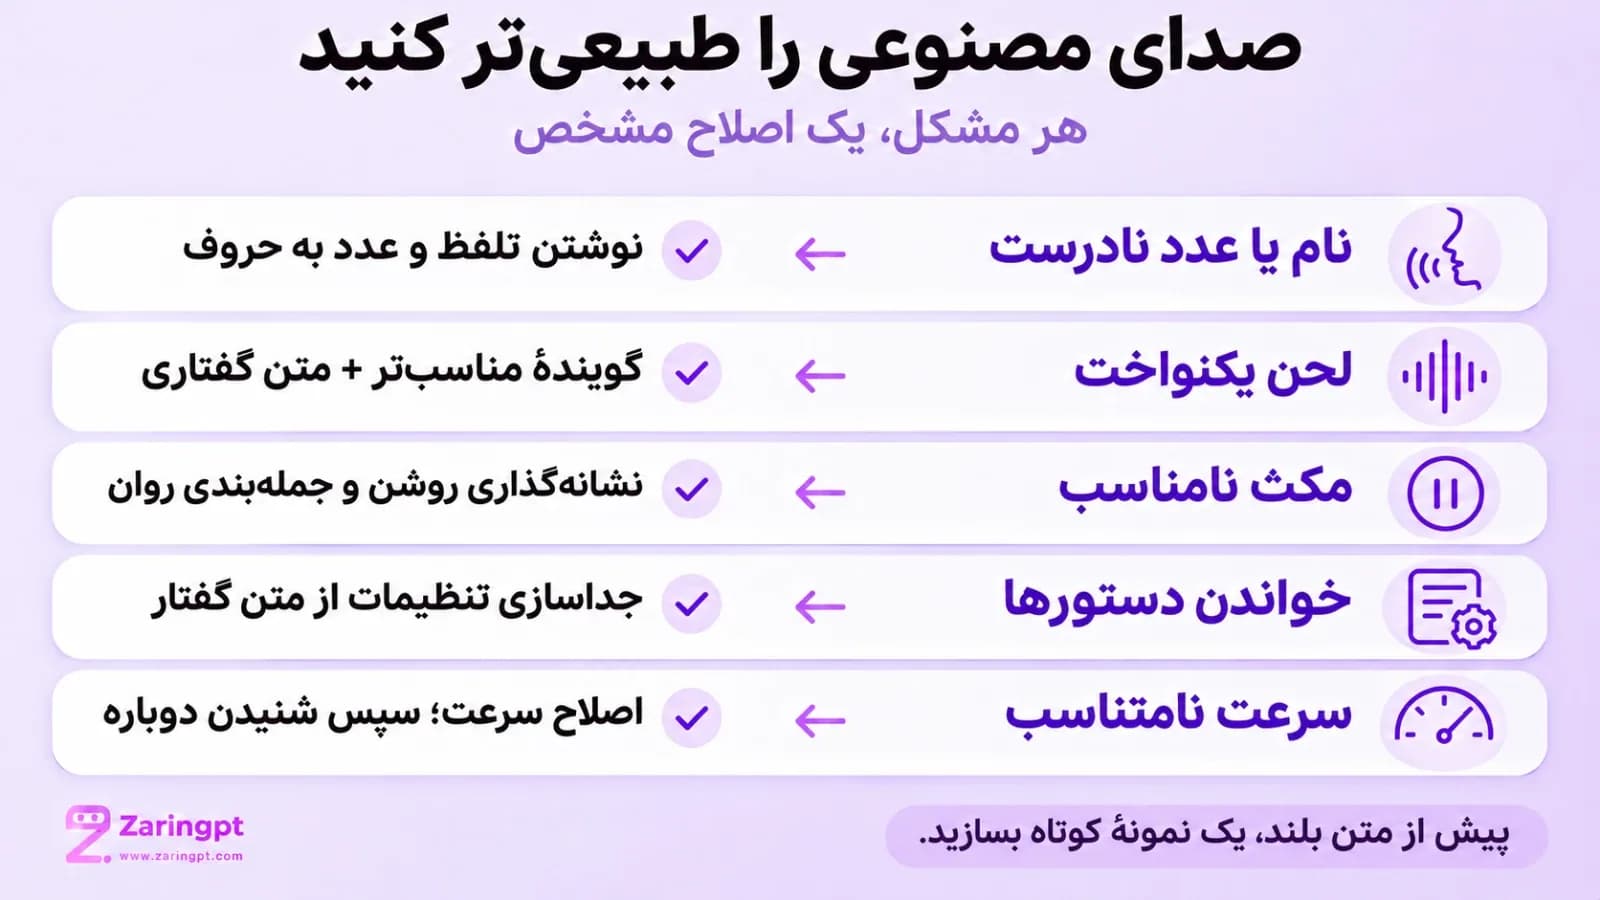
پیشنهادهای جدول زیر را جداگانه امتحان کنید و قبل از ساخت دوبارهٔ متن بلند، نتیجه را با جملهای کوتاه بسنجید.
| مشکل | اصلاح پیشنهادی |
|---|---|
| نام یا عدد نادرست | عدد را به حروف و نام را با تلفظ روشنتر بنویسید. |
| لحن یکنواخت | گویندهٔ مناسبتری انتخاب کنید و متن را برای شنیدن بازنویسی کنید. |
| مکث نامناسب | نشانهگذاری و ارتباط جملهها را اصلاح کنید، سپس تنظیم مکثِ پشتیبانیشده را بررسی کنید. |
| خواندن دستورها | دستور اجرا را از متن گفتار جدا کنید و قالب قابلقبول مدل را بررسی کنید. |
| سرعت نامتناسب | سرعت را اندکی تغییر دهید و نتیجه را روی محتوای نهایی بشنوید. |
استفادهٔ رایگان و انتشار تجاری چه شرایطی دارند؟
سهمیهٔ آزمایشی یک سازنده را با مجوز پروژهٔ تجاری یکسان ندانید. راهنمای رسمی ElevenLabs میگوید محتوای ساختهشده در پلن رایگان فقط برای استفادهٔ غیرتجاری و با ذکر نام ElevenLabs مجاز است و تولید در پلنهای پولی حقوق تجاری دارد. این توضیح دربارهٔ استفادهٔ مستقیم از سرویس ElevenLabs است. برای استفاده از خروجی در ZarinGPT باید شرایط همین پلتفرم را هم جدا بررسی کنید.
در ZarinGPT ارسال درخواست به اشتراک فعال و موجودی کافی نیاز دارد و استفاده از مدل تابع قوانین پلتفرم و سیاست سازنده است. برای تبلیغ یا پروژهٔ مشتری، شرایط استفاده از همان خروجی را روشن کنید و دربارهٔ مجوز از روی نام مدل حدس نزنید. داشتن فایل قابلدانلود بهتنهایی مجوز تمام کاربردها نیست.
برای ساخت نریشن معمولی، گویندهٔ آماده و مجاز انتخاب کنید. اگر قرار است صدای فرد واقعی را شبیهسازی کنید، اجازهٔ روشن و آگاهانهٔ او و شرایط سرویس اهمیت دارد. سیاست استفادهٔ ElevenLabs بخشی جداگانه دربارهٔ فریب، دستکاری و جعل هویت دارد و برای استفاده از صدای افراد بدون رضایتشان مسیر گزارش گذاشته است، پس صدای تولیدشده را بهعنوان ضبط واقعی فرد دیگری معرفی نکنید.
سؤالات متداول
آیا گفتارسازی همان گفتگوی صوتی زنده است؟
خیر، گفتارسازی متن آماده را به فایل صوتی تبدیل میکند، اما گفتگوی زنده به دریافت صدا و پاسخ تعاملی هم نیاز دارد. وجود یکی از این قابلیتها، فعال بودن دیگری را ثابت نمیکند.
برای ساخت نریشن به میکروفون نیاز داریم؟
اگر ورودی شما متن است، ضبط با میکروفون پیشنیاز تولید نیست. میکروفون زمانی لازم میشود که مسیر انتخابی به صدای ضبطشدهٔ شما نیاز داشته باشد.
چرا فایل روی موبایل و هدفون متفاوت شنیده میشود؟
هدفون و بلندگوی موبایل جزئیات صدا را یکسان پخش نمیکنند و محیط شنیدن هم بر وضوح گفتار اثر میگذارد. پیش از انتشار، نریشن را با هدفون و بلندگوی موبایل هم بررسی کنید تا واژههای کموضوح از قلم نیفتند.
میتوان گفتار را به فایل موسیقی تبدیل کرد؟
خواندن متن با گوینده، ساخت آهنگ نیست. اگر نریشن به موسیقی پسزمینه نیاز دارد، موسیقی را جدا با ابزار ساخت آهنگ با هوش مصنوعی آماده کنید و در تدوین، بلندی دو لایه را متعادل نگه دارید.
برای پروژهٔ چندقسمتی چه چیزهایی را ذخیره کنیم؟
نام مدل و گوینده، تنظیمات، متن نهایی و فایل اصلی را نگه دارید. این اطلاعات به حفظ شباهت اجراها کمک میکند، اما ثبات کامل خروجی یا موجود ماندن همیشگی یک گوینده را تضمین نمیکند.
قدم بعدی
برای شروع ساخت صدای دختر با هوش مصنوعی، یکی از دو متن کوتاه این راهنما را انتخاب کنید و با گویندهٔ زن و مرد بشنوید. همان اجرایی را ادامه دهید که تلفظ و لحنش با پروژه هماهنگتر است. در ZarinGPT، Eleven v3 یا MiniMax Speech 2.8 HD را از دستهٔ صدا انتخاب کنید و پیش از متن بلند، نمونهٔ کوتاه را بررسی کنید. پلن مناسب را هم در پلنهای ZarinGPT ببینید.
ZarinGPT از طریق API به مدلها دسترسی میدهد و اشتراک رسمی ElevenLabs یا MiniMax نیست.
پیشنویس این مطلب با کمک هوش مصنوعی آماده و توسط تحریریه ویرایش و فکتچک شد. مشخصات و شرایط بر پایهٔ منابع رسمی، در ۱۵ آبان ۱۴۰۵ بررسی شدهاند.
منابع
- مدلها و زبانهای ElevenLabs — ElevenLabs Docs
- کتابخانهٔ صدا و فیلترهای انتخاب گوینده — ElevenLabs Docs
- بهترین روشهای تبدیل متن به گفتار — ElevenLabs Docs
- افزودن مکث در مدلهای مختلف — ElevenLabs Help Center
- حقوق تجاری پلنها — ElevenLabs Docs
- پارامترها، مدلها و زبانهای Speech T2A — MiniMax API
- سیاست استفاده — ElevenLabs
آخرین بررسی تحریریه: · اگر نسخهٔ مدلها یا قیمتها تغییر کرده باشد، در همین صفحه بهروز میشود.
چیزی که خواندی را با هوش مصنوعی امتحان کن
چت با مدلهای GPT، Claude، Gemini و DeepSeek، ساخت تصویر و ویدیو و تبدیل متن به صدا؛ همه در یک پنل فارسی.